На рынке больших языковых моделей произошёл настоящий рывок: Alibaba представила Qwen3.8-Max и открыла доступ к её весам, DeepSeek обновила API до версии V4 Pro 0813, а xAI выпустила Grok 4.6.
При всех различиях между моделями у них есть общий вектор развития. Они постепенно уходят от роли обычных чат-ботов к полноценным AI-агентам, которые способны самостоятельно решать многоэтапные задачи — программировать, работать с инструментами, анализировать результаты и продолжать выполнение после ошибок.
Qwen3.8-Max: 2,4 трлн параметров и миллион токенов контекста
Alibaba представила Qwen3.8-Max как крупнейшую модель в линейке Qwen и открыла её веса. Модель использует архитектуру Mixture-of-Experts (MoE): общее количество параметров составляет около 2,4 трлн, однако на обработку каждого токена приходится примерно 95 млрд активных параметров. Всего в архитектуре 512 экспертов.
Такой подход позволяет значительно наращивать ёмкость модели без пропорционального увеличения вычислительных затрат.
Контекстное окно Qwen3.8-Max достигает 1 млн токенов. Это делает модель подходящей для работы с большими репозиториями, объёмными документами и длительными агентными сессиями.
По данным Alibaba, модель получила 86,6% на Terminal-Bench 2.1 и 93,0% на PaperBench.
DeepSeek V4 Pro 0813: большой контекст и низкая стоимость
DeepSeek обновила свою Pro-модель до версии DeepSeek-V4-Pro-0813. В официальном API заявлены контекст до 1 млн токенов, максимальный ответ размером до 384 тыс. токенов, поддержка tool calls, а также два режима — thinking и non-thinking.
Одним из главных преимуществ новой версии стала стоимость инференса:
Для агентных систем это особенно важно. Такие сценарии предполагают множество последовательных обращений к модели и повторную передачу уже обработанного контекста. Поэтому низкая стоимость cache-hit токенов может существенно снизить общие расходы.
По данным DeepSeek, версия 0813 улучшила результаты на ряде агентных тестов: до 87,9% на Terminal-Bench 2.1, 83,3% на CyberGym и 62,7% на DeepSWE. Эти показатели скорее демонстрируют направление развития модели — автономное программирование, работу с окружением и решение многоэтапных задач, — чем подтверждают её абсолютное превосходство над другими LLM.
Grok 4.6: ставка на продолжительную работу агентов
В тот же день xAI представила Grok 4.6. В новой версии компания также делает акцент не столько на обычном общении, сколько на продолжительном выполнении сложных задач: программировании, исследованиях, создании приложений и взаимодействии с инструментами.
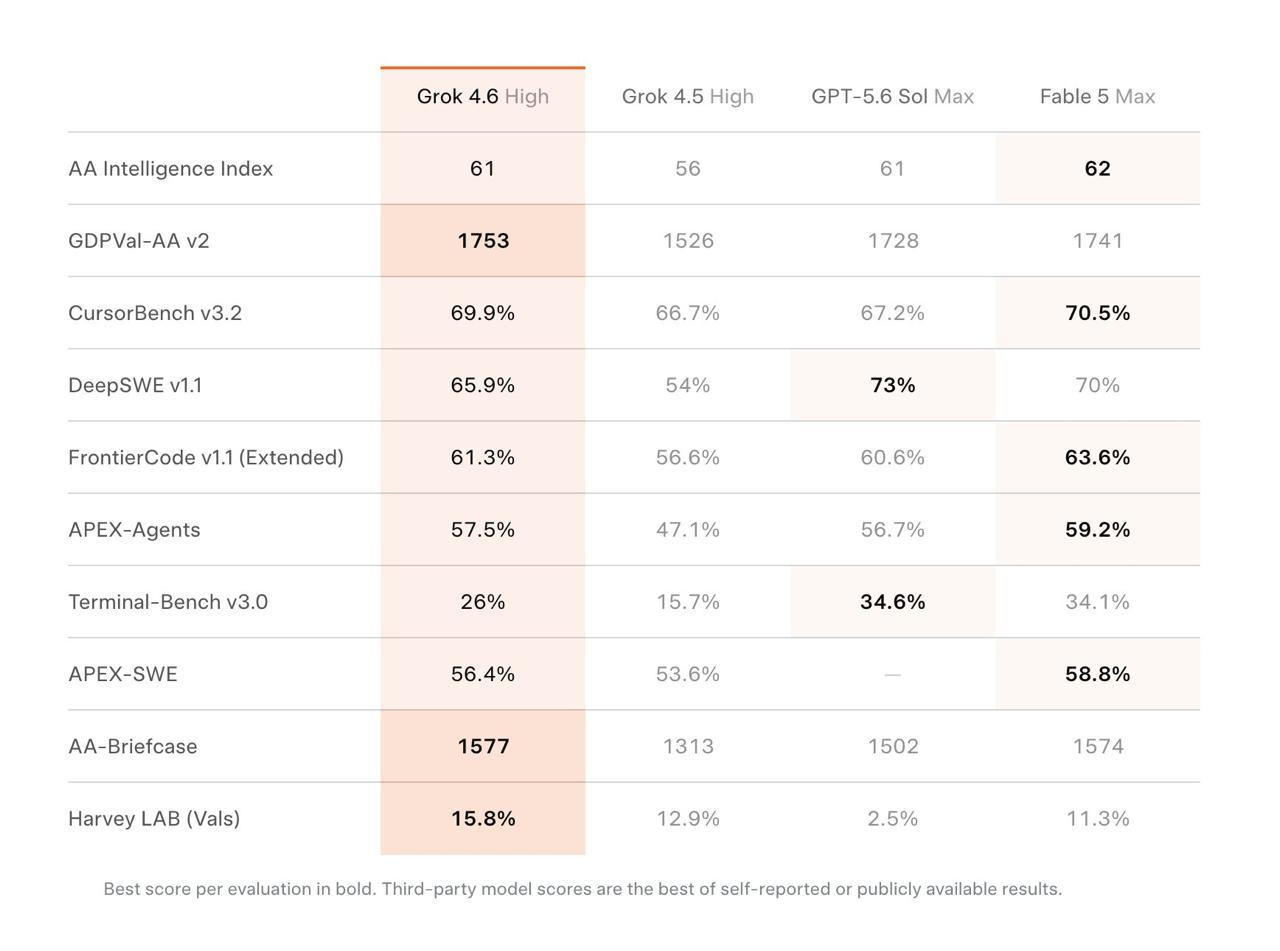
Согласно данным xAI, Grok 4.6 набрала 61 балл в Artificial Analysis Intelligence Index. На специализированных тестах модель показала 69,9% на CursorBench 3.2, 65,9% на DeepSWE 1.1 и 61,3% на FrontierCode 1.1 Extended.
xAI позиционирует модель для сценариев, где агенту приходится долго работать над одной задачей: использовать внешние инструменты, анализировать промежуточные результаты, находить ошибки и самостоятельно продолжать работу.
Ещё в Grok 4 компания активно использовала reinforcement learning для развития reasoning-навыков. Последующие продукты вокруг Grok всё сильнее смещаются в сторону агентного подхода.
Три модели — один вектор развития
Эти релизы хорошо показывают, куда сейчас движется индустрия LLM.
1. Количество параметров уже не является единственным показателем масштаба.
Qwen3.8-Max с 2,4 трлн параметров использует MoE и активирует только часть сети при обработке каждого токена. Это позволяет получить огромную ёмкость модели без вычислений по всей архитектуре на каждом шаге.
2. Длинный контекст превращается в важную часть инфраструктуры.
Миллион токенов позволяет держать в одном контексте крупный кодовый проект, историю взаимодействия с инструментами, результаты предыдущих действий и дополнительные документы. При этом большой контекст сам по себе не гарантирует эффективную работу модели со всем его содержимым.
3. Бенчмарки всё чаще проверяют самостоятельность моделей.
Terminal-Bench, DeepSWE и другие агентные тесты оценивают не только способность генерировать текст или код. Они проверяют, насколько хорошо модель взаимодействует с окружением, использует инструменты и доводит задачу до конечного результата.
4. Цена инференса становится частью практической эффективности.
Для обычного общения разница в стоимости нескольких миллионов токенов может быть несущественной. Но агент способен сделать десятки или сотни запросов, многократно передавать большой контекст и генерировать длинные цепочки действий. В таком сценарии стоимость токенов напрямую влияет на экономику продукта.
При всех различиях между моделями у них есть общий вектор развития. Они постепенно уходят от роли обычных чат-ботов к полноценным AI-агентам, которые способны самостоятельно решать многоэтапные задачи — программировать, работать с инструментами, анализировать результаты и продолжать выполнение после ошибок.
Qwen3.8-Max: 2,4 трлн параметров и миллион токенов контекста
Alibaba представила Qwen3.8-Max как крупнейшую модель в линейке Qwen и открыла её веса. Модель использует архитектуру Mixture-of-Experts (MoE): общее количество параметров составляет около 2,4 трлн, однако на обработку каждого токена приходится примерно 95 млрд активных параметров. Всего в архитектуре 512 экспертов.
Такой подход позволяет значительно наращивать ёмкость модели без пропорционального увеличения вычислительных затрат.
Контекстное окно Qwen3.8-Max достигает 1 млн токенов. Это делает модель подходящей для работы с большими репозиториями, объёмными документами и длительными агентными сессиями.
По данным Alibaba, модель получила 86,6% на Terminal-Bench 2.1 и 93,0% на PaperBench.
DeepSeek V4 Pro 0813: большой контекст и низкая стоимость
DeepSeek обновила свою Pro-модель до версии DeepSeek-V4-Pro-0813. В официальном API заявлены контекст до 1 млн токенов, максимальный ответ размером до 384 тыс. токенов, поддержка tool calls, а также два режима — thinking и non-thinking.
Одним из главных преимуществ новой версии стала стоимость инференса:
- $0,435 за 1 млн входных токенов при cache miss;
- $0,003625 за 1 млн входных токенов при cache hit;
- $0,87 за 1 млн выходных токенов.
Для агентных систем это особенно важно. Такие сценарии предполагают множество последовательных обращений к модели и повторную передачу уже обработанного контекста. Поэтому низкая стоимость cache-hit токенов может существенно снизить общие расходы.
По данным DeepSeek, версия 0813 улучшила результаты на ряде агентных тестов: до 87,9% на Terminal-Bench 2.1, 83,3% на CyberGym и 62,7% на DeepSWE. Эти показатели скорее демонстрируют направление развития модели — автономное программирование, работу с окружением и решение многоэтапных задач, — чем подтверждают её абсолютное превосходство над другими LLM.
Grok 4.6: ставка на продолжительную работу агентов
В тот же день xAI представила Grok 4.6. В новой версии компания также делает акцент не столько на обычном общении, сколько на продолжительном выполнении сложных задач: программировании, исследованиях, создании приложений и взаимодействии с инструментами.
Согласно данным xAI, Grok 4.6 набрала 61 балл в Artificial Analysis Intelligence Index. На специализированных тестах модель показала 69,9% на CursorBench 3.2, 65,9% на DeepSWE 1.1 и 61,3% на FrontierCode 1.1 Extended.
xAI позиционирует модель для сценариев, где агенту приходится долго работать над одной задачей: использовать внешние инструменты, анализировать промежуточные результаты, находить ошибки и самостоятельно продолжать работу.
Ещё в Grok 4 компания активно использовала reinforcement learning для развития reasoning-навыков. Последующие продукты вокруг Grok всё сильнее смещаются в сторону агентного подхода.
Три модели — один вектор развития
Эти релизы хорошо показывают, куда сейчас движется индустрия LLM.
1. Количество параметров уже не является единственным показателем масштаба.
Qwen3.8-Max с 2,4 трлн параметров использует MoE и активирует только часть сети при обработке каждого токена. Это позволяет получить огромную ёмкость модели без вычислений по всей архитектуре на каждом шаге.
2. Длинный контекст превращается в важную часть инфраструктуры.
Миллион токенов позволяет держать в одном контексте крупный кодовый проект, историю взаимодействия с инструментами, результаты предыдущих действий и дополнительные документы. При этом большой контекст сам по себе не гарантирует эффективную работу модели со всем его содержимым.
3. Бенчмарки всё чаще проверяют самостоятельность моделей.
Terminal-Bench, DeepSWE и другие агентные тесты оценивают не только способность генерировать текст или код. Они проверяют, насколько хорошо модель взаимодействует с окружением, использует инструменты и доводит задачу до конечного результата.
4. Цена инференса становится частью практической эффективности.
Для обычного общения разница в стоимости нескольких миллионов токенов может быть несущественной. Но агент способен сделать десятки или сотни запросов, многократно передавать большой контекст и генерировать длинные цепочки действий. В таком сценарии стоимость токенов напрямую влияет на экономику продукта.